Інші види динамичних структур
Стеки
Стек - динамічна структура даних, яка представляє собою впорядкований набір елементів, в якому додавання нових елементів і видалення існуючих проходить з одного кінця, який називається вершиною стека. Стек реалізує принцип LIFO (last in - first out, останнім прийшов - першим пішов). Найбільш наглядним прикладом організації стеку може бути дитяча пірамідка, де додавання і знімання кілець здійснюється як раз відповідно до цього принципу.
Основні операції, які можна виконувати над стеками :
- додавання елемента в стек;
- вилучення елемента із стека;
- перевірка, чи порожній стек;
- перегляд елемента у вершині стека без видалення;
- очистка стека.
Стек створюється так само, як і лінійний список, так як стек є частковим випадком однозв'язного списку.
typedef long elemtype;
typedef struct node
{
elemtype val;
struct node *next;
} stack;.
Реалізація основних операцій над стеками.
1. Початкове формування стеку.
stack *first(elemtype d)
{
stack *pv=(stack*) calloc(1,sizeof(stack));
pv->val=d;
pv->next=NULL;
return pv;
}.
2. Занесення значення в стек.
void push(stack **top,elemtype d)
{
stack *pv=(stack*) calloc(1,sizeof(stack));
pv->val=d;
pv->next=*top;
*top=pv;
}.
3. Вилучення елемента зі стека.
elemtype pop(stack **top)
{
elemtype temp=(*top)->val;
stack *pv=*top;
*top=(*top)->next;
free(pv);
return temp;
}.
Черги
Черга - це лінійний список, де елементи вилучаються з початку списку, а додаються в кінець (як звичайна черга в магазині).
Двостороння черга - це лінійний список, у якого операції додавання, вилучення і доступу до елементів можливі як спочатку так і в кінці списку. Таку чергу можна уявити як послідовність книг, що стоять на полиці так, що доступ до них можливий з обох кінців.
Черга є частковим випадком односпрямованого списку. Вона реалізує принцип FIFO (first in - first out, першим прийшов - першим пішов).
Черги створюються аналогічно до лінійних списків та стеків.
typedef long elemtype;
typedef struct node
{
elemtype val;
struct node *next;
} queue;
1. Початкове формування черги.
queue *first (elemtype d)
{
queue *pv=(queue*) calloc(1,sizeof(queue));
pv->val=d;
pv->next=NULL;
return pv;
}
2. Додавання елемента в кінець.
void add (queue **pend, elemtype d)
{
queue *pv=(queue*) calloc(1,sizeof(queue));
pv->val=d;
pv->next=NULL;
(*pend)->next=pv;
*pend=pv;
}
3. Вилучення елемента з кінця.
elemtype del(queue **pbeg)
{
elemtype temp=(*pbeg)->val
queue *pv=*pbeg;
*pbeg=(*pbeg)->next;
free(pv);
return temp;
}
Двійкові дерева
Бінарне(двійкове) дерево - це динамічна структура даних, що складається з вузлів (елементів), кожен з яких містить, окрім даних, не більше двох посилань на інші бінарні дерева(рис.9). На кожен вузол припадає рівно одне посилання. Початковий вузол називається коренем дерева Якщо дерево організоване таким чином, що для кожного вузла всі ключі його лівого піддерева менші за ключ цього вузла, а всі ключі його правого піддерева - більші, воно називається деревом пошуку. Однакові ключі в деревах пошуку не допускаються.
В дереві пошуку можна знайти елемент за ключем, рухаючись від кореня і переходячи на ліве або праве піддерево в залежності від значення ключа в кожному вузлі. Такий спосіб набагато ефективніший пошуку по списку, так як час виконання операції пошуку визначається висотою дерева.
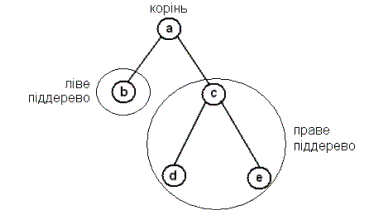
Рисунок 9 - Схематичне зображення бінарного дерева
Дерево є рекурсивною структурою даних, так як кожне піддерево є також деревом. Дії з такими структурами даних простіше всього описувати за допомогою рекурсивних алгоритмів. Наприклад, функцію обходу всіх вузлів дерева в загальному вигляді можна описати так :
function way(дерево)
{
way(ліве піддерево);
обробка кореня;
way(праве піддерево);
};.
Можна обходити дерево і в іншому порядку, наприклад, спочатку корінь, а потім піддерева. Але наведена модель функції дозволяє отримати на виході відсортовану послідовність ключів, так як спочатку відвідуються вершини з меншими ключами, що розташовані в лівому піддереві. Таким чином, дерева пошуку можна використовувати для сортування значень. При обході дерева вузли не видаляються.
Для бінарних дерев визначені наступні операції :
- включення вузла у дерево;
- пошук по дереву;
- обхід дерева;
- видалення вузла.
Для кожного рекурсивного алгоритму можна створити його нерекурсивний еквівалент.
Вузол бінарного дерева можна визначити як :
typedef struct sbtree
{
int val;
struct sbtree *left,*right;
} btree;
Реалізація деяких операцій з бінарними деревами.
1.. Рекурсивний пошук в бінарному дереві. Функція повертає покажчик на знайдений вузол.
btree *Search(btree *p, int v)
{
if (p==NULL) return(NULL); /* порожня */
if (p->val == v) return(p); /* вершина знайдена */
if (p->val > v) /* порівняння з поточним вузлом */
return(Search(p->left,v)); /* ліве піддерево */
else
return(Search(p->right,v)); /* праве піддерево */
}
2. Включення значення в двійкове дерево (рис.10).
btree *Insert(btree *pp, int v)
{
if (pp == NULL) /* знайдена порожня вітка */
{
btree *q = (btree*) calloc(1,sizeof(btree)); /* створити вершину дерева */
q->val = v; /* і повернути покажчик */
q->left = q->right = NULL;
return q;
}
if (pp->val == v) return pp;
if (pp->val > v) /* перейти в ліве піддерево */
pp->left=Insert(pp->left,v);
else
pp->right=Insert(pp->right,v);
/* перейти в праве піддерево*/
return pp;
}
3. Рекурсивний обхід двійкового дерева.
void Scan(btree *p)
{
if (p==NULL) return;
Scan(p->left);
printf("%i\n",p->val);
Scan(p->right);
}
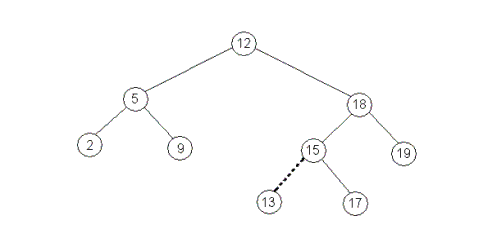
Рискнок 10 - Схема включення нового елемента у бінарне дерево
В усіх програмах, де використовувались функції malloc та free, можно використати функції new та delete.